
석사과정에서 읽었던 스튜어트 러셀과 피터 노빅의 『인공지능: 현대적 접근방식』에는 에이전트를 한 장에 걸쳐 설명하는 부분이 있다. 당시에는 인공지능의 기본 구조를 정리한 이론으로 읽었다. 최근 에이전틱 AI라는 용어를 자주 접하면서 이 책의 2장, “Intelligent Agents”가 다시 생각났다. 지금 이야기하는 에이전틱 AI는 책에서 설명한 지능형 에이전트와 어떤 관계가 있을까. 그 내용을 확인해보고 싶어 이 글을 쓰게 되었다.
석사과정에서는 이 책의 원서 2판으로 공부했다. 이후 개정된 4판의 한국어 번역서가 출간되었고, 이 글을 준비하면서는 원서 3판도 함께 참고했다. 글의 출발점은 당시 읽었던 2판이지만, 본문에 실은 인용문과 그림 번호, 쪽수는 원서 3판을 기준으로 했다. 주요 개념의 한국어 표현과 도서 정보는 한국어판 4판을 참고했으며, 판본에 따라 위치가 달라질 수 있는 내용은 출처에 기준 판본을 표시했다.
2장은 인공지능을 개별 알고리즘이나 인간과 비슷한 대화 능력으로 설명하기에 앞서, 환경을 지각하고 그 안에서 행동하는 에이전트의 문제로 정리한다. 에이전트 함수와 에이전트 프로그램의 구분, 합리성을 판단하는 성과 척도, 과업 환경의 성격을 설명한 뒤 단순 반사 에이전트에서 모델 기반·목표 기반·효용 기반·학습 에이전트로 구조를 확장한다. 오늘날 에이전틱 AI를 설명할 때 빠지지 않는 계획, 도구 사용, 기억, 평가, 자율 실행의 바탕이 되는 개념을 이 장에서 함께 확인할 수 있다. 그래서 이 글에서는 이 책의 2장을 기준으로 고전적인 지능형 에이전트와 현재의 에이전틱 AI를 비교해보려 한다.
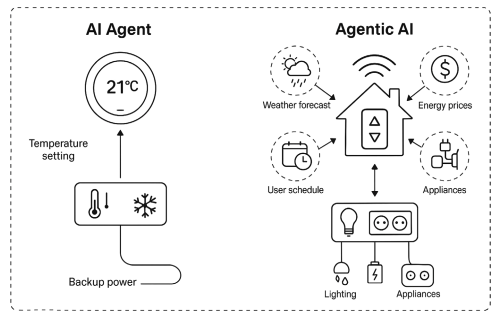
글 첫머리에 실은 그림은 두 개념의 차이를 집 안의 온도 관리 사례로 보여준다. 왼쪽의 AI Agent는 사용자가 정한 온도를 유지하는 한 가지 과업을 수행한다. 오른쪽의 Agentic AI는 날씨와 전기요금, 사용자의 일정, 조명과 가전, 보안 상태를 담당하는 여러 에이전트가 정보를 주고받으며 집 전체의 상태를 관리한다. 왼쪽이 정해진 입력과 과업에 반응하는 개별 에이전트라면, 오른쪽은 여러 역할과 도구를 조정하면서 더 긴 작업을 처리하는 시스템이다.
이 그림은 Ranjan Sapkota, Konstantinos I. Roumeliotis, Manoj Karkee가 발표한 리뷰 논문의 분류를 따른다. 다만 ‘AI Agent’와 ‘Agentic AI’의 경계가 모든 연구자와 기업에서 똑같이 쓰이는 것은 아니다. 단일 에이전트가 계획을 수정하며 여러 도구를 사용하는 시스템도 흔히 에이전틱 AI라고 부른다. 이 글은 어느 명칭이 옳은지를 판정하기보다, 『인공지능: 현대적 접근방식』 2장이 제시한 지각, 행동, 목표, 효용, 학습의 틀을 이용해 무엇이 이어졌고 무엇이 달라졌는지를 비교한다.

책에서 정의한 지능형 에이전트
첫 그림의 왼쪽에 있는 온도조절기부터 살펴보면 책의 정의를 이해하기 쉽다. 온도조절기가 하는 일은 단순하지만, 주변 온도를 읽고 난방이나 냉방을 작동해 환경의 상태를 바꾼다는 점에서 에이전트의 조건을 갖춘다. 이 책은 지능을 인간의 사고 과정과 비슷한 것으로 한정하지 않고, 어떤 시스템이 환경에서 정보를 받아 어떻게 행동하는지를 기준으로 설명한다. 시스템 내부에서 정보를 잘 표현하는 것만으로는 충분하지 않다. 그 정보가 행동의 선택으로 이어지는지, 선택한 행동이 환경에 어떤 변화를 만드는지도 함께 살펴야 한다.
“An agent is anything that can be viewed as perceiving its environment through sensors and acting upon that environment through actuators.”
에이전트란 센서를 통해 환경을 지각하고, 액추에이터를 통해 그 환경에 행동하는 것으로 볼 수 있는 모든 것이다.
이 정의 덕분에 인간과 로봇, 소프트웨어를 같은 틀에서 이야기할 수 있다. 사람에게 눈과 귀가 센서이고 손과 발이 액추에이터라면, 로봇에서는 카메라와 거리 측정기, 모터가 그 자리를 차지한다. 소프트웨어는 키 입력과 파일, 네트워크 패킷을 받아들이고 화면 출력이나 파일 기록, 네트워크 전송으로 환경에 개입한다. 오늘날의 사례로 바꾸어 말해도 어색하지 않다. 브라우저에서 자료를 찾고, 저장소의 코드를 고치고, 업무 시스템에 결과를 남기는 AI 역시 입력을 받고 행동한다.
다만 대규모 언어 모델 자체를 곧바로 에이전트라고 부르면 중요한 구분 하나가 흐려진다. 책은 에이전트 함수와 에이전트 프로그램을 나눈다. 전자는 지금까지 들어온 지각의 연속에 어떤 행동을 대응시킬지 표현한 추상적인 함수이고, 후자는 그 함수를 실제 기계에서 돌아가게 만든 구현이다. 이 구분을 빌리면 언어 모델은 에이전트 전체라기보다 다음 행동을 고르는 핵심 부품에 가깝다. 기억을 어디에 남길지, 어떤 도구를 연결할지, 어느 범위까지 권한을 줄지, 언제 일을 끝냈다고 판단할지가 모델 바깥에서 정해져야 비로소 하나의 시스템이 된다.
책에서 말하는 센서와 액추에이터를 현재의 소프트웨어 환경에 대응시켜 볼 수 있다. 프롬프트, 문서, 화면, 검색 결과는 에이전트가 받아들이는 입력에 해당한다. API와 코드 실행기, 브라우저, 업무 애플리케이션은 외부 시스템을 실제로 변경하는 행동 수단이다. 구현 방식은 크게 달라졌지만 환경을 관찰하고, 다음 행동을 판단하고, 행동의 결과를 다시 확인하는 과정은 그대로 남아 있다.
합리적 행동을 판단하는 기준
에이전트를 정의하고 나면 곧 어려운 질문이 따라온다. 여러 행동 가운데 무엇을 ‘좋은 행동’이라고 할 것인가. 러셀과 노빅이 말하는 합리성은 미래를 모두 아는 전지성과 다르다. 합리적 에이전트도 틀릴 수 있다. 다만 판단하는 시점까지 얻은 지각, 이미 가진 지식, 가능한 행동, 주어진 성과 척도를 바탕으로 가장 나은 결과가 기대되는 쪽을 고른다. 결과가 나빴다는 이유만으로 그때의 선택까지 반드시 비합리적이었다고 단정할 수 없는 이유도 여기에 있다.
책은 이 판단을 성과 척도, 환경에 관한 사전 지식, 가능한 행동, 현재까지의 지각 순서라는 네 요소로 풀어낸다. 그중에서도 성과 척도는 요즘 에이전트 설계에서 자주 놓치는 부분이다. 청소 에이전트에게 ‘치운 먼지의 양’만 보상한다고 해보자. 먼지를 일부러 뿌린 뒤 다시 치우는 편법도 높은 점수를 받을 수 있다. 오래된 교과서의 예지만, 오늘날 말하는 보상 해킹이나 대리 지표의 실패와 거의 같은 문제다. 무엇을 할 수 있는 모델인가를 따지기 전에 무엇을 잘한 것으로 셀 것인가를 정해야 한다.
합리성은 에이전트가 놓인 환경과도 떨어뜨려 생각할 수 없다. 모든 상태가 보이는지, 행동의 결과가 확정적인지, 지금의 선택이 다음 단계에 영향을 주는지, 다른 행위자와 상호작용하는지에 따라 필요한 구조가 달라진다. 웹과 코드 저장소, 기업의 내부 시스템은 일부 상태만 드러나며 수시로 변한다. 이런 환경에서는 한 번 그럴듯한 답을 내는 능력보다 행동한 뒤 결과를 확인하고 이전 판단을 수정하는 능력이 중요하다.
 그림 2.13 · 목표 기반 에이전트출처: Russell & Norvig, 『인공지능: 현대적 접근방식』 원서 3판, p.52.
“Knowing something about the current state of the environment is not always enough to decide what to do.”
환경의 현재 상태를 아는 것만으로는 무엇을 해야 할지 결정하기에 충분하지 않다.
그림 2.13에서 눈여겨볼 대목은 ‘현재 상태’만으로 행동이 정해지지 않는다는 점이다. 에이전트는 세계가 어떻게 변하는지, 자신의 행동이 어떤 결과를 낳을지 어느 정도 예상해야 한다. 그런 다음 예상한 미래가 목표에 가까운지 비교한다. 한 번의 행동으로 끝나지 않는다면 여러 행동을 잇는 경로를 찾아야 하고, 여기서 탐색과 계획의 문제가 시작된다.
보고서 작성 같은 요즘의 에이전트 작업을 떠올려보면 이 설명이 낯설지 않다. 먼저 필요한 자료의 범위를 정하고, 검색하고, 출처를 가려내고, 비어 있는 부분을 다시 찾은 뒤 초안을 쓴다. 마지막에는 처음 요청한 조건과 결과를 대조해야 한다. 언어 모델이 교과서의 탐색 알고리즘처럼 고정된 상태 공간을 훑는 것은 아닐 수 있다. 그러나 목표를 기준으로 다음 행동을 고르고, 도구가 돌려준 결과를 보고 계획을 바꾼다는 점에서는 목표 기반 에이전트의 문제를 그대로 풀고 있다.
고전적 에이전트와 현재 기술의 대응 관계
현재의 에이전틱 AI를 과거 에이전트 모델의 최신판이라고만 설명하기는 어렵다. 대규모 언어 모델의 학습 방식은 당시의 전통적인 에이전트 프로그램과 다르며, 처리할 수 있는 자연어의 범위와 연결 가능한 도구의 규모도 크게 늘었다. 다만 시스템의 구성 요소가 맡는 역할을 비교하면, 지각·상태·목표·행동·평가라는 기존 개념이 현재의 기술에서 어떻게 구현되고 있는지는 확인할 수 있다.
책에 나오는 단순 반사, 모델 기반, 목표 기반, 효용 기반, 학습 에이전트는 서로 단절된 유형이라기보다 필요한 기능이 차례로 추가되는 구조로 읽을 수 있다. 반사형은 현재 입력에 맞는 규칙을 골라 행동한다. 모델 기반 에이전트는 직접 관찰할 수 없는 상태를 내부에 기록한다. 목표 기반 에이전트는 가능한 미래를 예상하고, 효용 기반 에이전트는 여러 결과의 가치를 비교한다. 학습 에이전트는 실제 결과에서 얻은 피드백을 다음 행동에 반영한다.
“경쟁사 동향 보고서를 작성하라”는 요청을 예로 들어보자. 사용자 요청은 목표와 완료 조건이 되고, 검색 결과와 문서는 환경에서 들어온 지각이 된다. 수집한 사실과 남은 할 일은 메모리나 작업 상태에 보관한다. 검색과 문서 작성 도구는 외부 시스템에 접근하거나 결과를 기록하는 행동 수단이다. 초안이 나온 뒤에는 출처가 빠졌는지, 요구한 형식에 맞는지 검사하고, 부족하면 검색 단계로 돌아간다. 이 과정은 관찰, 상태 갱신, 행동 선택, 실행, 결과 확인의 순서로 진행된다.
첫 그림의 오른쪽에서는 이 과정에 여러 에이전트가 참여한다. 날씨를 확인하는 역할, 전력 비용을 계산하는 역할, 가전을 제어하는 역할이 나뉘고, 조정 역할을 맡은 계층이 각각의 결과를 집 전체의 목표에 맞게 종합한다. 분석 범위를 집 전체로 넓히면 이 시스템 전체도 하나의 에이전트로 볼 수 있다. 개별 에이전트는 다른 에이전트의 메시지를 입력으로 받아들이고, 전체 시스템은 집과 사용자라는 더 큰 환경을 대상으로 행동한다. 고전적인 에이전트 정의는 개별 구성 요소와 전체 시스템에 각각 적용될 수 있다.
대규모 언어 모델 이후 달라진 점
공통된 구조가 있다고 해서 과거와 현재의 기술적 차이가 작은 것은 아니다. 가장 큰 변화는 다음 행동을 선택하는 과정에 범용 대규모 언어 모델이 사용된다는 점이다. 전통적인 구현에서는 설계자가 상태를 어떻게 표현할지, 어떤 조건에서 무슨 행동을 할지, 환경이 어떻게 변하는지, 어디까지 탐색할지를 상당 부분 미리 정해야 했다. 현재의 언어 모델은 학습 과정에서 얻은 표현 능력을 이용해 자연어 지시를 해석하고, 처음 접하는 작업을 여러 단계로 나누며, 도구 설명을 읽고 적절한 도구를 선택한다. 과거에는 프로그램의 규칙으로 작성해야 했던 일부 판단을 이제 모델이 실행 중에 처리한다.
그 결과 에이전트가 다룰 수 있는 환경도 크게 넓어졌다. 과거의 대표적인 예는 체스판이나 진공청소기 세계처럼 상태와 행동의 경계가 비교적 또렷했다. 반면 LLM 기반 에이전트가 마주하는 것은 이메일, 문서, 웹페이지, 소스 코드, 데이터베이스다. 형식도 제각각이고 어디까지가 하나의 상태인지도 명확하지 않다. 자연어가 이 서로 다른 환경을 잇는 공통 인터페이스가 되었고, 각 환경을 실제로 읽고 바꾸는 도구들이 뒤를 받쳤다. 오늘날 말하는 범용성은 모델 하나의 성질이 아니라 모델과 도구 계층이 함께 만든 결과다.
최근의 실무 문서에서도 이와 비슷한 구분을 확인할 수 있다. OpenAI는 에이전트의 기본 요소를 모델, 도구, 지시로 나눈다. 모델이 판단을 맡고, 도구가 외부 시스템을 읽거나 바꾸며, 지시가 역할과 제약을 정한다는 설명이다. Anthropic은 코드에 미리 정해 둔 순서를 따르는 워크플로와 모델이 처리 순서와 도구 사용을 상황에 따라 결정하는 에이전트를 구분한다. 사용하는 용어에는 차이가 있지만, 목표와 제약에 따라 환경의 정보를 읽고 행동한 뒤 그 결과를 다시 판단한다는 구조는 책의 설명과 연결된다.
그러나 현재의 에이전틱 AI를 기호주의 에이전트가 점차 발전한 결과라고 설명하는 것도 정확하지 않다. 현재의 시스템에는 기존의 에이전트 개념뿐 아니라 딥러닝 기반 언어 모델, 강화학습, 검색과 계획, 소프트웨어 도구 연결 기술이 함께 사용된다. Sapkota 등의 논문은 단일 에이전트와 조정된 다중 에이전트 시스템의 차이에 초점을 맞춘다. 반면 다른 문헌과 제품에서는 하나의 모델이 계획을 세우고 도구를 반복해서 호출하는 경우도 에이전틱 AI에 포함한다. 용어의 범위는 아직 통일되지 않았지만, 과거에 정리된 에이전트의 문제를 새로운 학습 모델과 실행 환경에서 다시 구현하고 있다는 점은 공통적으로 확인할 수 있다.
문장을 생성하는 능력만으로 언어 모델을 에이전트라고 부르기는 어렵다. 사용자의 목표를 여러 단계에 걸쳐 유지하고, 외부에서 정보를 얻거나 실제 행동을 수행하며, 그 결과에 따라 다음 선택을 바꿀 때 에이전트로서의 특성이 분명해진다. 자율성 역시 있거나 없는 두 상태로 나뉘지 않는다. 다음 단계를 누가 결정하는지, 시스템에 어느 범위까지 행동 권한을 맡겼는지에 따라 자율성의 정도가 달라진다.
에이전틱 AI를 설계할 때 확인할 문제
에이전트에게 도구와 권한을 더 줄수록, 책에서 다룬 성과 척도와 환경 설계는 교과서 속 주제가 아니라 운영상의 위험이 된다. 목표를 잘못 적으면 시스템은 사용자가 바라던 결과 대신 측정하기 쉬운 숫자를 쫓는다. 권한을 넓게 열어두면 틀린 판단 하나가 메시지 전송이나 파일 변경, 심지어 거래 실행으로 이어질 수 있다. 그래서 안전을 모델의 답변 품질만 검사하는 일로 좁혀서는 안 된다. 무엇을 볼 수 있게 할지, 어떤 행동을 허용할지, 어느 순간 사람의 승인을 받을지, 성공과 실패를 무엇으로 판단할지까지 시스템 수준에서 정해야 한다.
 그림 2.15 · 일반 학습 에이전트출처: Russell & Norvig, 『인공지능: 현대적 접근방식』 원서 3판, p.55.
그림 2.15는 학습 에이전트를 수행 요소, 비평가, 학습 요소, 문제 생성기로 나눈다. 수행 요소가 외부 행동을 고르면 비평가는 성과 기준에 비추어 결과를 평가하고, 학습 요소는 그 피드백으로 수행 방식을 바꾼다. 문제 생성기는 이미 효과가 확인된 행동만 반복하지 않고, 장기적인 학습에 도움이 되는 새로운 행동도 시도하게 한다. 오늘날의 모델 학습과 실행 과정을 이 도식만으로 모두 설명할 수는 없다. 다만 수행과 평가를 분리하고, 평가 결과를 다음 행동에 반영해야 한다는 기본 원리는 현재의 시스템에도 적용된다.
현재의 시스템에서는 이러한 역할이 하나의 프로그램 안에 모두 들어 있지 않을 수 있다. 사전 학습과 후속 학습은 모델의 장기적인 능력을 만들고, 실행 단계의 검증 도구와 평가 모델은 개별 결과를 검사한다. 사용자 승인, 테스트, 출처 확인, 감사 로그는 에이전트가 실제로 무엇을 했는지 확인하고 잘못된 행동을 멈추거나 되돌리는 장치다. 신뢰할 수 있는 에이전트를 논할 때 인간의 통제와 투명성, 보안, 개인정보 보호를 함께 다루는 이유도 여기에 있다. 텍스트 답변의 오류와 외부 시스템을 변경할 권한을 가진 에이전트의 오류는 영향 범위가 다르다.
기억도 빼놓기 어렵다. 디지털 환경에서 도구가 돌려준 결과는 완전하지 않을 수 있고, 작업이 길어지면 앞 단계에서 내린 결정과 근거가 컨텍스트 밖으로 밀려난다. 대화 내용을 오래 저장하는 것만으로는 부족하다. 어느 사실을 어디서 얻었는지, 무엇을 끝냈는지, 아직 지켜야 할 제약이 무엇인지, 어떤 시도가 실패했는지를 구조적으로 남겨야 한다. 보이지 않는 세계의 상태를 내부적으로 추정하고 유지한다는 모델 기반 에이전트의 문제가 다른 모습으로 되돌아온 것이다.
첫 그림의 왼쪽과 오른쪽 사이에는 분명한 기술적 차이가 있다. 정해진 값을 유지하는 제어기와 여러 에이전트가 정보를 공유하며 상황에 따라 역할을 나누는 시스템은 같은 방식으로 구현되지 않는다. 그러나 두 시스템 모두 환경에서 정보를 얻고 목표에 맞는 행동을 선택한다. 현재의 에이전틱 AI는 과거의 에이전트 개념과 단절된 기술도 아니고, 기존 에이전트에 언어 모델 하나를 추가한 기술도 아니다. 환경을 지각하고 행동하는 시스템이라는 기존의 설계 관점에 범용 언어 모델, 디지털 도구, 자연어 인터페이스가 결합하면서 처리할 수 있는 작업의 범위가 크게 넓어진 결과로 이해하는 것이 적절하다.
이런 이유로 『인공지능: 현대적 접근방식』 2장은 현재의 에이전틱 AI를 이해하는 데에도 참고할 만하다. 에이전트가 어떤 정보를 입력으로 받는지, 작업 상태를 어떻게 기억하는지, 어떤 목표와 성과 기준을 따르는지, 어디까지 행동할 수 있는지, 실패를 어떻게 확인하고 수정하는지는 지금도 시스템을 설계할 때 결정해야 하는 항목이다. 구현에 사용하는 기술은 달라졌지만, 지능을 환경 안에서 목표에 따라 행동하는 시스템으로 분석하는 관점은 여전히 유효하다.
출처와 더 읽을거리
- Stuart Russell & Peter Norvig, Artificial Intelligence: A Modern Approach, 3rd ed., Chapter 2 “Intelligent Agents,” pp.34-55. 본문의 인용문과 Figure 2.1, 2.13, 2.15의 출처.
- 스튜어트 러셀·피터 노빅 저, 류광 역, 『인공지능 1: 현대적 접근방식』 제4판, 제이펍, 2021년 8월 25일, ISBN 9791191600315. 한국어판 도서 정보.
- Ranjan Sapkota, Konstantinos I. Roumeliotis & Manoj Karkee, “AI Agents vs. Agentic AI: A Conceptual Taxonomy, Applications and Challenges,” Information Fusion, Vol. 126, 2026, Article 103599. AI 에이전트와 에이전틱 AI의 개념적 구분, 아키텍처 변화와 활용 분야를 정리한 리뷰 논문.
- 『Artificial Intelligence: A Modern Approach』 공식 사이트 - 책의 판본, 목차, 교육 자료.
- OpenAI, A practical guide to building agents - 현대 에이전트의 모델·도구·지시 구성.
- Anthropic, Building effective agents - 워크플로와 에이전트의 구분, 도구 사용 루프.
- Anthropic, Trustworthy agents in practice - 인간의 통제, 투명성, 보안과 에이전트의 자기 주도적 루프.
'IT > Cloud' 카테고리의 다른 글
| [Datadog] Prometheus Cardinality가 비용이 되는 순간 (0) | 2026.07.01 |
|---|---|
| [Prometheus] Label 하나가 시스템을 느리게 만든다 - 2. Cardinality (0) | 2026.06.21 |
| [Prometheus] Label 하나가 시스템을 느리게 만든다 - 1. Metric, Label, TimeSeries (0) | 2026.06.21 |
| [Prometheus] 왜 다들 프로메테우스를 사용할까 (0) | 2026.05.31 |
| [DevOps] 왜 DevOps는 결국 GitOps로 향하게 되었을까 (0) | 2026.05.17 |
 [Datadog] Prometheus Cardinality가 비용이 되는 순간
 [Prometheus] Label 하나가 시스템을 느리게 만든다 - 2. Cardinality
 [Prometheus] Label 하나가 시스템을 느리게 만든다 - 1. Metric, Label, TimeSeries
 [Prometheus] 왜 다들 프로메테우스를 사용할까